
LLMs lokal ausführen mit Ollama und n8n

Warum kleine lokale Modelle einen Blick wert sind
KI ist für Service Desks und Ops-Teams längst Pflichtprogramm. Doch jeder Cloud-Call kostet drei Dinge: Latenz, Geld und Compliance-Sicherheit. Kleine lokale Modelle ändern das: Ihre Daten bleiben bei Ihnen und es fallen keine Gebühren pro Token an.
Warum Cloud-Aufrufe Automatisierung bremsen
Jeder Aufruf bei einem Hyperscaler kostet einen Roundtrip über das Internet. Bei Tausenden Automationen pro Tag bedeutet das:
- Höhere Kosten: Token-Gebühren für jeden Aufruf
- Unsichere Compliance: Die DSGVO mag keine Cross-Border-Transfers
- Entwicklungsaufwand: wechselnde APIs, Rate Limits, Vendor-Lock-in
Lokale LLMs lösen diese Blocker - aber: Welches Modell? Welche GPU? Wie als API für n8n exponieren?
Ollama und n8n auf eigener Hardware
S&S Technologies bündelt Ollama (leichter Modell-Server) mit gehärteten n8n Workflow-Runners. Ollama hostet Modelle on-prem; n8n orchestriert Prompts, Kontextfenster und Post-Processing. Zusammen betreiben sie Ihre Automatisierungen unter Ihrer eigenen Kontrolle. Automatisieren. Optimieren. Skalieren.
Modelle wählen, dimensionieren und installieren
1. Modellklassen & Use Cases
| Modellklasse | Typische Größe | Ideal für | Beispiel-Prompt |
|---|---|---|---|
| SLMs (Small Language Models) | 3-7 B Parameter | Echtzeit-Chat, Ticket-Triage | „Fasse dieses Ticket in 20 Wörtern zusammen und vergebe eine Priorität.“ |
| Vision-fähige LLMs | 7-13 B | OCR, Screenshot-Analyse, Rechnungs-QA | „Sag mir, ob auf dieser Rechnung eine PO-Nummer fehlt.“ |
| „Thinking“-Modelle (Reasoning-getuned) | 7-13 B mit größerem Kontext | Root-Cause-Analyse, Multi-Step-Automationen | „Gib anhand dieser Log-Auszüge eine Fehlerhypothese und nächste Schritte aus.“ |
2. Modellwahl
- Phi-3-mini-4K-instruct (3,8 B): kleines, schnelles SLM für Chat/Klassifikation
- Gemma-2-9B-it: Allzweckmodell mit 8K Kontext für anspruchsvollere Aufgaben
- Llava-1.6-7B: Versteht Bilder, etwa für die QA von GUI-Screenshots
- OpenHermes-2.5-Mistral-7B: auf Anweisungen trainiertes Mistral 7B für allgemeine Aufgaben
Tipp: Halten Sie ein SLM und ein Vision-Modell immer geladen; starten Sie ein schwereres „Thinking“-Modell nur bei Bedarf.
3. Hardware-Check
- CPU-only Pilot: Moderner 8-Kern-Laptop; reicht für erste Tests, antwortet aber langsamer als mit GPU
- GPU-Mindestmaß: NVIDIA RTX 4060 (8 GB VRAM) oder besser, damit jedes der Modelle oben in den GPU-Speicher passt
- RAM: genug für das Betriebssystem und die Modelle, die Sie geladen halten; mehr, wenn Sie mehrere im Wechsel laden
- Disk: Die Modelle oben belegen so, wie Ollama sie herunterlädt, je 2-6 GB (Ollama-Bibliothek) - auf NVMe für schnelle Loads speichern
4. Ollama & n8n installieren - Quick Links
# macOS / Linux
curl -fsSL https://ollama.com/install.sh | sh
# dann
ollama pull gemma2:9b
# Ollama läuft jetzt auf http://localhost:11434
Vollständige Anleitung: siehe die Ollama-Installationsdokumentation.
n8n neben Ollama zu betreiben ist genauso simpel:
- Self-Host (Docker): Folgen Sie dem n8n Docker Quick-Start
- Cloud-Test: Starten Sie eine Testinstanz auf n8n Cloud
Beide Wege funktionieren - der einzige Unterschied ist, wo die Workflow-Engine läuft.
5. Verkabelung in n8n - eingebaute AI-Nodes
| # | Aktion | Warum es wichtig ist |
|---|---|---|
| 1 | In Credentials → Ollama Base URL auf http://localhost:11434 (oder Container-Namen) setzen. Dann einen Ollama Model-Node (Completions) oder Ollama Chat Model-Node (Chat) droppen. |
Native Node = keine Custom-HTTP-Calls und bessere Fehlerbehandlung |
| 2 | Single-Shot Prompts: Modell in Basic LLM Chain einwickeln.Multi-Tool Reasoning: Modell in einen AI Agent füttern und Tool-Nodes (Web Search, SQL, HTTP ...) anhängen. | Repliziert LangChain-Patterns innerhalb von n8n |
| 3 | Chain/Agent-Output an Ihr Zielsystem binden - z. B. mit dem S&S Technologies Matrix42 n8n Node (vollständiges Tutorial in unserem Beitrag zum Matrix42-Node). | Ein Node verwandelt KI-Insights in Ticket-Anreicherung |
Zusammengesetzt sieht ein Workflow, der Tickets mit einem lokalen Modell bearbeitet, so aus:
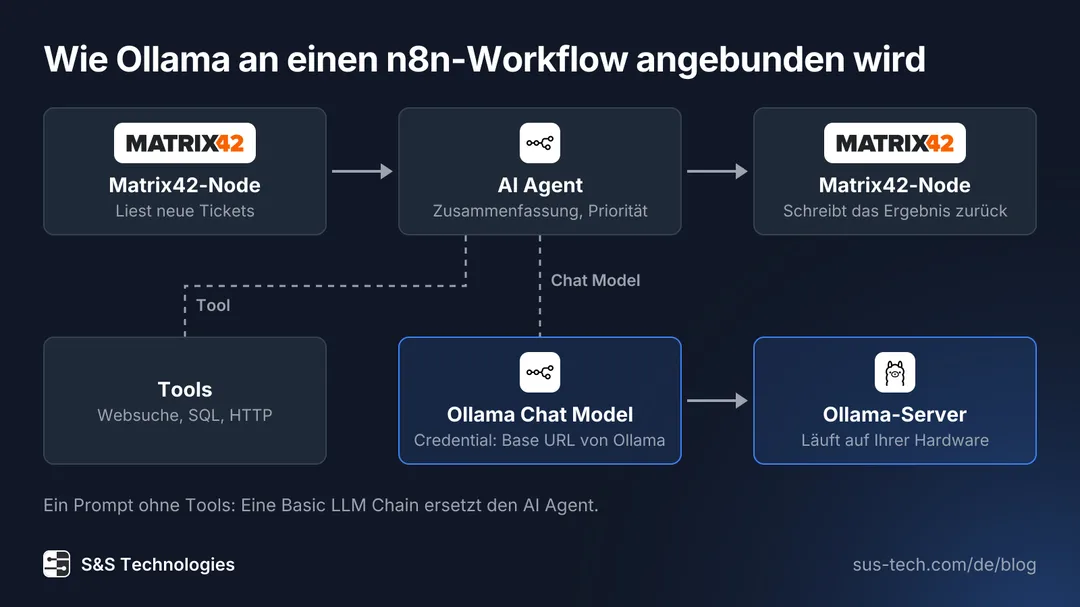
Ein Matrix42-Node liest neue Tickets und übergibt sie dem AI Agent. Das Sprachmodell bekommt der Agent vom Node „Ollama Chat Model“, der den Ollama-Server auf Ihrer Hardware über die Base URL in seinen Credentials erreicht. Tools wie Websuche, SQL oder ein HTTP-Request hängen auf dieselbe Weise am Agent. Ein zweiter Matrix42-Node schreibt Zusammenfassung und Priorität zurück ins Ticket. Für einen einzelnen Prompt ohne Tools ersetzt eine Basic LLM Chain den Agent.
Cloud und lokal im Vergleich
| Cloud-LLM | Lokales Ollama + n8n | |
|---|---|---|
| Antwortzeit | Roundtrip über das Netz plus Warteschlange beim Anbieter | Kein Roundtrip; hängt von GPU und Modellgröße ab |
| Kosten | Pro Token, wachsen mit jedem Aufruf | Einmal Hardware, danach Strom |
| Datenresidenz | Beim Anbieter | On-Prem |
Im Pilot unten messen Sie Antwortzeiten und Token-Volumen an Ihren eigenen Workflows; daran sehen Sie schnell, welches Setup passt.
Ein Pilot in einer Woche
Checkliste für den Pilot in einer Woche
- Prüfen Sie, ob Workstation oder Server die GPU- und RAM-Ziele erfüllt
- Installieren Sie Ollama und laden Sie Phi-3-mini und Gemma-2-9B
- Bauen Sie Ihren eigenen Workflow oder kontaktieren Sie unser Team für einen schnellen Start
- Schicken Sie Test-Tickets und Rechnungen durch die neuen Nodes
- Messen Sie Latenz und Genauigkeit
- Produktions-Rollout entscheiden
Möchten Sie das mit Ihren eigenen Workflows testen? Kontaktieren Sie unser Team und legen Sie los!