
Interne Wissensdatenbanken mit RAG: Architektur, Tools und Wartung

Montagmorgen. Ihr Service-Desk-Agent wirft ein 300-seitiges Compliance-PDF in einen n8n-Workflow. Zehn Minuten später kann jede*r Mitarbeitende natürliche Fragen stellen und erhält Antworten - jede mit Seiten-Zitation. Automate. Optimize. Scale.
Wissen verstreut über PDFs und Wikis
Wissen liegt verstreut in PDFs, Wikis und SharePoint-Libraries. Keyword-Suche liefert Trefferlisten ohne Kontext.
- Langsame Ticket-Bearbeitung und frustrierte Teams
- Gefahr veralteter Richtlinien und Compliance-Verstöße
- Manuelle Pflege, die bei Volumenwachstum kollabiert
Retrieval-Augmented Generation
Retrieval-Augmented Generation (RAG) rüstet ein Sprachmodell mit aktuellen, kontrollierten Daten auf. Statt sich auf Pre-Training zu verlassen, holt RAG passende Dokument-Chunks aus einem Vektorspeicher und übergibt sie dem LLM - inklusive Quellenangaben.
Rund um RAG bauen wir eine Pipeline für den Produktivbetrieb mit n8n:
- Ingest: Dateien, URLs, Datenbanken
- Chunk & Embed: Text splitten, Vektoren erstellen
- Store: Embeddings in Milvus oder pgvector
- Query: Chat-UI, API oder ITSM-Widget
- Governance: RBAC, Versionierung, Audit Trail
Für Datenhoheit hosten wir das LLM lokal mit Ollama, wie in den Beiträgen DSGVO & KI: Sicheres lokales Hosting für LLMs oder LLMs lokal ausführen mit Ollama und n8n beschrieben.
Eine RAG-Wissensdatenbank Schritt für Schritt
Eine RAG-Wissensdatenbank hat zwei Teile mit einem gemeinsamen Vektorspeicher: Die Indexierung bereitet neue und geänderte Dokumente auf, die Beantwortung nutzt sie bei jeder Frage.
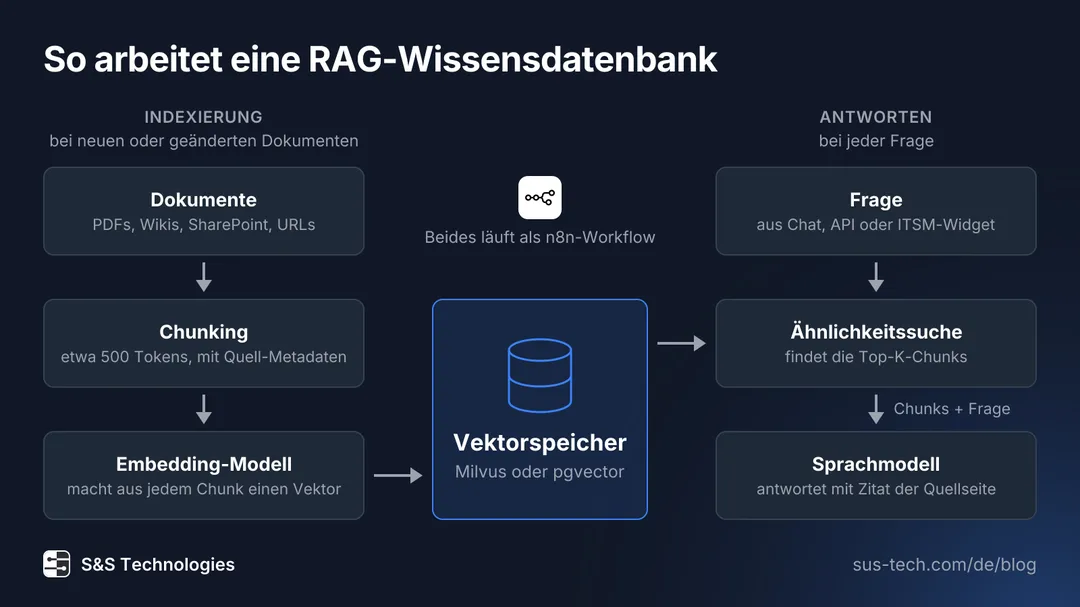
Die Indexierung zerlegt jedes Dokument in Chunks von etwa 500 Tokens, macht mit einem Embedding-Modell Vektoren daraus und legt sie in Milvus oder pgvector ab. Bei jeder Frage findet eine Ähnlichkeitssuche die Top-K-Chunks und das Sprachmodell antwortet daraus mit Zitat der Quellseite. Beide Teile laufen als n8n-Workflows. Die fünf Schritte unten beschreiben sie genauer.
1 - Ingestion & Chunking
Ein n8n-Trigger überwacht Ordner, S3-Buckets oder SharePoint. Neue PDFs werden extrahiert, in semantisch kohärente Chunks (etwa 500 Tokens) zerlegt und mit Metadaten versehen.
2 - Embeddings & Vektorspeicher
Chunks durchlaufen ein Embedding-Modell - OpenAI, Instructor XL oder On-Premise-Modelle - und landen als dichte Vektoren in Milvus oder pgvector. Inkrementelle Updates halten den Index frisch.
3 - Retrieval + Generation
Bei jeder Frage führt die RAG-Schicht eine Ähnlichkeitssuche durch, wählt Top-K-Chunks und sendet sie mit der Query an das LLM. Das Modell formuliert eine Antwort im Ton Ihres Unternehmens und hängt Zitationen an - Schluss mit „Black Box“.
4 - Chat-UX & Integration
Ein schlankes React-Widget oder ein natives Panel in Ihrer ITSM-Software liefert das Chat-Erlebnis. Mouse-Over zeigt die PDF-Seite, Log-Daten sichern Audit-Pflichten.
5 - Governance & Monitoring
Alle Artefakte leben in Git-versionierten n8n-Workflows mit RBAC. Geplante Process-Mining-Jobs analysieren Nutzung, markieren veraltete Inhalte und schlagen Automationen vor.
Was Teams gewinnen
Was sich für das Team ändert:
- Schnellere Ticket-Bearbeitung, weil Antworten in Sekunden gefunden statt gesucht werden
- Weniger Fragen, die eine Fachperson brauchen, weil die Wissensdatenbank die Routinefragen beantwortet
- Weniger Suchzeit in wissensintensiven Abläufen
- Vollständiger Audit Trail für ISO 27001 & DSGVO
Eingebettet in das Hilfemodul eines ERP-Systems verkürzt der RAG-Chat auch die Einarbeitung neuer Mitarbeiter: Sie fragen den Chat statt einer Kollegin.
Wie wir sie einrichten
Möchten Sie Ihre Daten einfacher zugänglich machen? Wir gehen in drei Schritten vor:
- 3-tägiger Discovery-Workshop: Quellen, Sicherheit, KPIs
- Pilot (2 - 4 Wochen): Dokumente ingestieren, Vektorspeicher & Chat-UI
- Roll-out mit Messung: Baseline, Iteration, Übergabe mit Playbooks
Kontaktieren Sie unser Team und sichern Sie sich Ihren Workshop-Termin.