
RAG vs. Finetuning: Die richtige Strategie für Ihre LLMs

Wann sollten Sie Ihr KI-Modell trainieren - und wann sollten Sie ihm einfach beibringen, die richtigen Informationen abzurufen? Da große Sprachmodelle (LLMs) zunehmend Unternehmensanwendungen in Österreich und darüber hinaus unterstützen, müssen CIOs und Verantwortliche für Service-Operationen den Unterschied zwischen Retrieval-Augmented Generation (RAG) und Finetuning verstehen. Ihre Entscheidung beeinflusst alles - von Leistung und Compliance über das Vertrauen der Kunden bis hin zur Kapitalrendite (ROI).
Zwei Wege, ein Sprachmodell anzupassen
Viele Unternehmen stehen vor derselben Frage: Wie lassen sich LLMs für den eigenen Geschäftskontext gezielt optimieren? Die zugrunde liegenden Daten sind häufig proprietär, reguliert oder einem stetigen Wandel unterworfen. Eine falsche Strategie kann zu ungenauen Ergebnissen, steigenden Kosten oder nicht skalierbarer Infrastruktur führen.
Ein Beispiel: Ein statisch feinabgestimmtes Modell für dynamische Produktanfragen - oder ein generischer Chatbot in einem gesetzlich regulierten Sektor - kann folgende Probleme verursachen:
- Geringe Genauigkeit aufgrund veralteter Trainingsdaten
- Hohe Kosten durch lange Kontext-Prompts
- Fehlende Governance und mangelnde Nachvollziehbarkeit von Quellen
Wie in Interne Wissensdatenbanken mit RAG: Architektur, Tools und Wartung erläutert, sollten technische Entscheider prüfen, wie häufig sich die Wissensbasis ändert, welche Domänen der Chatbot abdecken soll und welche Vertrauensanforderungen (z. B. DSGVO) bestehen.
RAG, Finetuning oder beides
Bei S&S Technologies unterstützen wir Unternehmen in Österreich und der gesamten EU dabei, die richtige Methode - oder Kombination - aus RAG und Finetuning zu wählen. Unser Team analysiert:
- Datenvolatilität: Ändert sich Ihr Wissen täglich, monatlich oder bleibt es weitgehend stabil?
- Vertrauen in Inferenz: Müssen Antworten mit Quellen belegt sein oder genügt generelles Modellverhalten?
- Domänenanpassung: Benötigt Ihr Bereich (Finanzen, Recht, Versicherung) spezifische Formate oder Tonalitäten?
Diese strategische Beratung kombinieren wir mit praktischer Umsetzung und unserer Expertise in Workflow-Automatisierung, kontrollierter Automatisierung und Orchestrierung von AI Agents. Unsere Lösungen integrieren sich in ERP-Plattformen, ITSM-Tools und sichere, EU-basierte Infrastrukturen.
Automatisieren. Optimieren. Skalieren.
Wie wir RAG und Finetuning umsetzen
Wir setzen beide Methoden um und kombinieren sie oft.
Die beiden Methoden legen Ihr Wissen an verschiedenen Stellen ab:
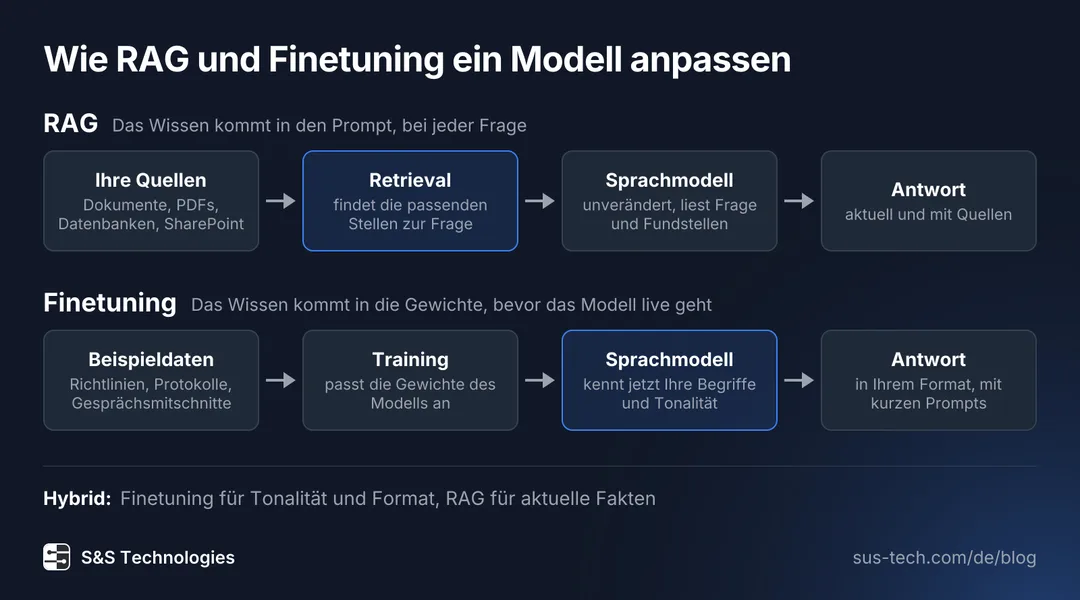
RAG lässt das Modell unverändert und fügt dem Prompt die passenden Stellen zu jeder Frage hinzu, so bleiben die Antworten aktuell und nennen ihre Quellen. Finetuning trainiert das Modell vor dem Einsatz mit beschrifteten Beispielen, so steckt das Wissen in den Gewichten und die Prompts bleiben kurz. Ein hybrider Ansatz nutzt Finetuning für Tonalität und Format und RAG für aktuelle Fakten.
Retrieval-Augmented Generation (RAG):
- Interne Dokumente, SQL-Datenbanken, PDFs oder SharePoint-Ressourcen werden über n8n mit verschlüsselten Vektor-Datenbanken an eine Retriever-Pipeline angebunden
- Bei einer Benutzeranfrage wird der relevanteste Kontext aus dem Dokumentencorpus abgerufen und dem Prompt des LLM hinzugefügt
- So bleiben die Ausgaben aktuell, Halluzinationen werden reduziert und Quellen nachvollziehbar
Finetuning:
- Verwendung von beschrifteten, domänenspezifischen Datensätzen (z. B. Richtlinien, Sicherheitsprotokolle, Gesprächsmitschnitte)
- Wir passen die Gewichte des Modells an, damit es Ihre Sprache, Prozesse und Tonalitäten intrinsisch versteht
- Führt zu schnelleren Antworten, geringeren Rechenkosten und besserer Branchenkonformität
Hybrider Ansatz:
- Beide Methoden für komplexe Anwendungen kombinieren
- Beispiel: Ein Modell für juristische Sprache feinjustieren - aber aktuelle Rechtsprechung über RAG einspielen
- DSGVO-konforme Bereitstellung in EU-Datenzentren oder On-Premise-Edge-Knoten (mehr dazu)
Was die richtige Wahl bringt
Die richtige Optimierungsstrategie bietet klare Vorteile:
- RAG-Pipelines reduzieren Halluzinationen, weil Antworten auf gefundenen Quellen beruhen - besonders wichtig in regulierten Branchen
- Feinjustierte Modelle brauchen kürzere Prompts, das senkt Inferenzzeit und Rechenkosten
- Eine höhere Transparenz stärkt das Vertrauen der Kunden - entscheidend in Finanz- und Versicherungssektoren
- Einheitliche Sprache, Terminologie und Fachwissen sorgen für bessere UX und Konformität
- Unterstützt durch moderne Tools (z. B. n8n) und vollständige Protokollierung für das Verarbeitungsverzeichnis nach Artikel 30 DSGVO
Mit unseren Frameworks für kontrollierte Automatisierung laufen alle Optimierungen in einer sicheren, nachvollziehbaren Architektur.
So entscheiden Sie für Ihren Anwendungsfall
So treffen Sie die richtige Entscheidung für Ihren Anwendungsfall:
- Daten inventarisieren. Strukturiert oder unstrukturiert? Statisch oder dynamisch?
- Use Case definieren. Chatbots, Dokumentenzusammenfassungen, Formularautomatisierung?
- Vertrauensbedarf prüfen. Sind Zitationen und Quellenangaben erforderlich?
- Infrastruktur bewerten. Können Modelle On-Premise oder in EU-Datenzentren betrieben werden?
- Kombinieren, wenn nötig. Finetuning für Tonalität und Verhalten; RAG für Aktualität und Präzision
Die Übersicht zeigt, welcher Bedarf zu welcher Methode führt:
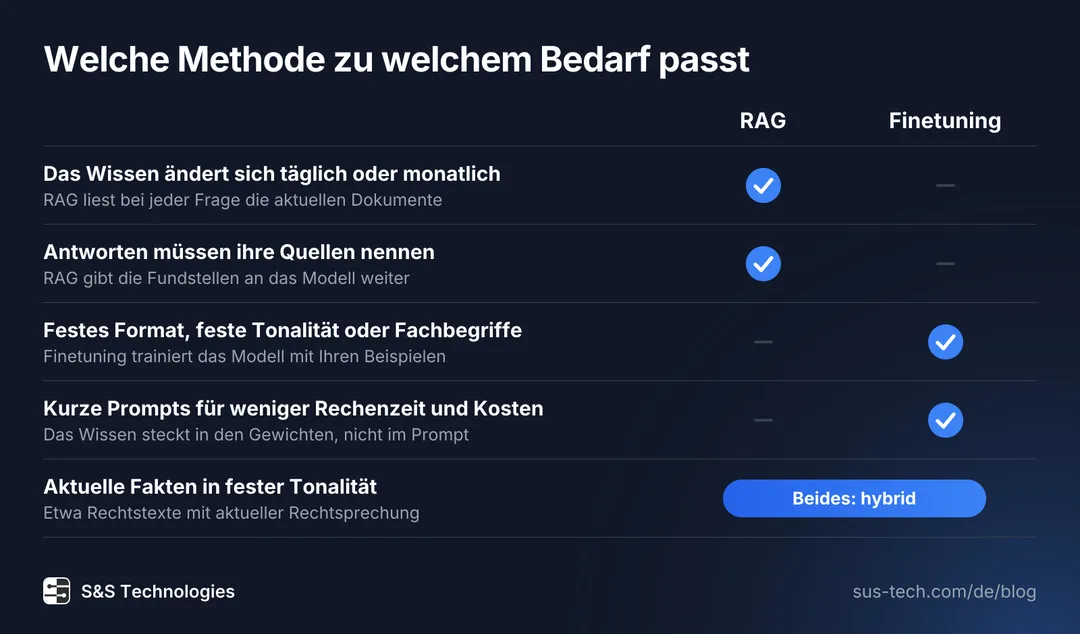
Wissen, das sich täglich oder monatlich ändert, und Antworten, die ihre Quellen nennen müssen, sprechen für RAG. Ein festes Format, eine feste Tonalität oder Fachbegriffe und kurze Prompts sprechen für Finetuning. Braucht ein Anwendungsfall aktuelle Fakten in fester Tonalität, etwa Rechtstexte mit aktueller Rechtsprechung, werden beide kombiniert.
Bereit für skalierbare, präzise und DSGVO-konforme AI-Workflows? Kontaktieren Sie unser Team unter office@sus-tech.at, um loszulegen.