
GPT-OSS: OpenAIs Open-Source-Modelle als Alternative zu proprietären LLMs

Mit der Einführung von gpt-oss-120b und gpt-oss-20b im August 2025, seinen ersten Open-Weight-Sprachmodellen seit GPT-2, markiert OpenAI einen Wendepunkt für Enterprise-KI: Unternehmen können Open-Weight-Modelle einsetzen, die nahe an die proprietären Modelle von OpenAI herankommen - zu ihren eigenen Bedingungen. Damit werden skalierbare, sichere und rechtskonforme KI-Workflows möglich, die lokal, am Edge oder in Private Clouds betrieben werden können.
S&S Technologies GmbH unterstützt Sie dabei, dieses Potenzial voll auszuschöpfen. Was bedeutet das konkret für Ihr Unternehmen?
Zwischen Cloud-KI und Compliance
Trotz des Booms rund um generative KI fühlen sich viele Unternehmen zwischen Innovationsdruck und Compliance-Anforderungen gefangen. Der Einsatz proprietärer LLMs aus der Cloud bringt erhebliche Herausforderungen mit sich:
- Unklare Datenresidenz: Selbst „EU-gehostete APIs“ können Telemetrie oder Logs in außereuropäische Rechenzentren replizieren.
- Unvorhersehbare Kosten: Kosten pro Token können bei zunehmender Nutzung schnell explodieren.
- Eingeschränkte Integration: Externe LLMs lassen sich meist nur schwer in bestehende ERP-, Security- oder ITSM-Systeme integrieren.
- Vendor-Lock-in: Individuelle Lösungen bleiben dauerhaft an Drittanbieter-APIs gebunden.
Diese Hürden bremsen die KI-Adoption erheblich und bergen - gerade im Hinblick auf DSGVO, ISO 27001 und nationale Aufbewahrungspflichten - erhebliche Risiken.
Open-Weight-Modelle in der eigenen Infrastruktur
Mit gpt-oss-120b und gpt-oss-20b bietet S&S Technologies Ihnen jetzt die Möglichkeit, leistungsstarke und sichere AI Agents direkt in Ihrer eigenen Infrastruktur aufzubauen. Diese Modelle zeichnen sich aus durch:
- Benchmark-Ergebnisse nahe an OpenAIs eigenen geschlossenen Modellen: Laut OpenAI erreicht gpt-oss-120b bei zentralen Reasoning-Benchmarks nahezu das Niveau von o4-mini, gpt-oss-20b liefert ähnliche Ergebnisse wie o3-mini (OpenAI)
- Starke Ergebnisse bei logischem Denken, Tool-Nutzung und Few-Shot-Funktionsaufrufen
- Offene Apache-2.0-Lizenz ohne API-Abhängigkeit
Die Modellkarte von OpenAI liefert die Zahlen zum ersten Punkt:
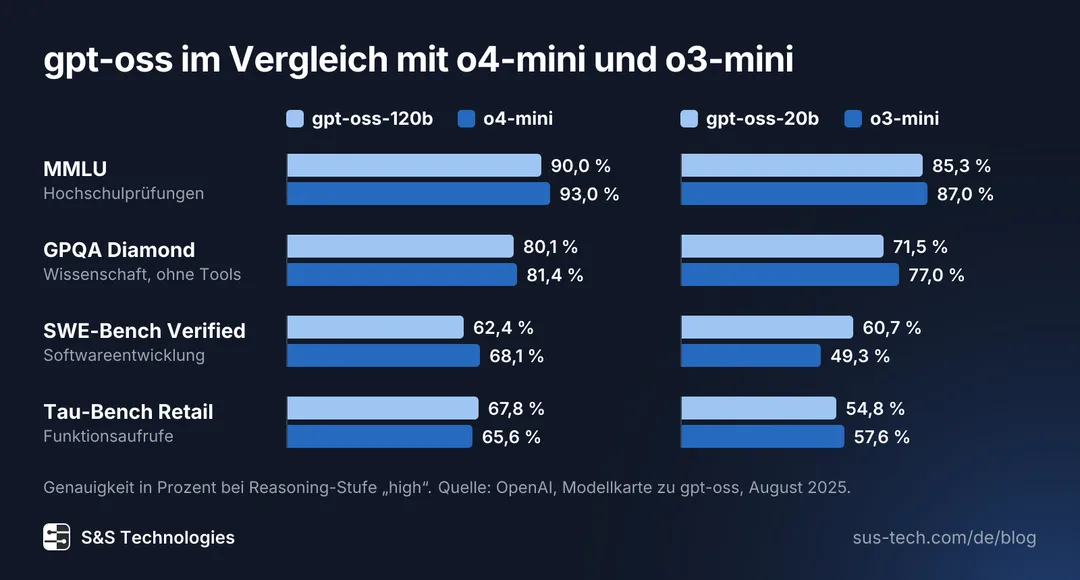
Bei MMLU erreicht gpt-oss-120b 90,0 % gegenüber 93,0 % für o4-mini, bei GPQA Diamond 80,1 % gegenüber 81,4 %. Bei Funktionsaufrufen im Tau-Bench Retail liegt es mit 67,8 % knapp vor o4-mini mit 65,6 %. Das zählt für Agenten, die Tools aufrufen. Das kleinere gpt-oss-20b liegt bei MMLU nahe an o3-mini (85,3 % gegenüber 87,0 %), bei GPQA Diamond dahinter (71,5 % gegenüber 77,0 %) und bei SWE-Bench Verified deutlich vorn (60,7 % gegenüber 49,3 %). Alle Werte hat OpenAI auf der höchsten Reasoning-Stufe gemessen (Modellkarte).
Wir kombinieren diese Open-Weight-Modelle mit unserer Erfahrung im DSGVO-konformen LLM-Hosting sowie Tools zur Workflow-Automatisierung wie n8n, um maßgeschneiderte, kontrollierte KI-Services zu bauen.
Wie wir gpt-oss betreiben
Unsere Bereitstellungsarchitektur ist flexibel, skalierbar und stellt den Datenschutz in den Mittelpunkt:
- Modellauswahl & Feinjustierung: Je nach Bedarf wählen wir gemeinsam gpt-oss-20b für Edge-Nutzung oder gpt-oss-120b für hohe Komplexität. Beide werden bereits mit MXFP4-Quantisierung ausgeliefert, was den Speicherbedarf für den lokalen Betrieb gering hält.
- Deployment: Betrieb On-Premise, in EU-Clouds oder hybriden Umgebungen - via Docker, Kubernetes oder Edge-Node.
- Workflow-Automatisierung: Integration in ERP- und ITSM-Systeme über n8n, Event-Listener und Richtlinien-gesteuerte Prompts.
- Governance-Layer: Einhaltung durch unsere AI-Governance-Schicht mit Prompt-Auditing, Chain-of-Thought-Tracking und Sicherheitsstandardisierung basierend auf dem Preparedness Framework von OpenAI.
- Individuelles Wissen einbinden: Integration lokaler Vektor-Datenbanken zur Retrieval-Augmented Generation (RAG) - z. B. aus Support-Tickets, Produktdokumentation oder Compliance-Richtlinien.
Dieser Ansatz orientiert sich an bewährten Methoden aus unserem Vergleich von RAG vs. Finetuning-Strategien - für maximale Kontrolle durch kombinierbare Optionen.
Was Unternehmen gewinnen
Unternehmen, die mit S&S Technologies und der GPT-OSS-Architektur arbeiten, profitieren von:
- Keine API-Gebühren pro Token: Bei hohen Volumen kostet die Hardware weniger als die API (siehe unseren Kostenvergleich)
- Schnellere Antworten, weil Anfragen nicht zu einem Cloud-Anbieter laufen
- Verarbeitung vollständig im eigenen Haus, das erleichtert DSGVO- und Betriebsratsanforderungen
- Leistungsprofile nach Maß: gpt-oss-20b läuft auf Geräten mit 16 GB Speicher, gpt-oss-120b auf einer einzelnen 80-GB-GPU (OpenAI)
- Maximale Anpassbarkeit: volle Modellkontrolle für Domänenoptimierung oder Tool-Anbindung
Welches der beiden Modelle passt, hängt vor allem von Ihrer Hardware ab:
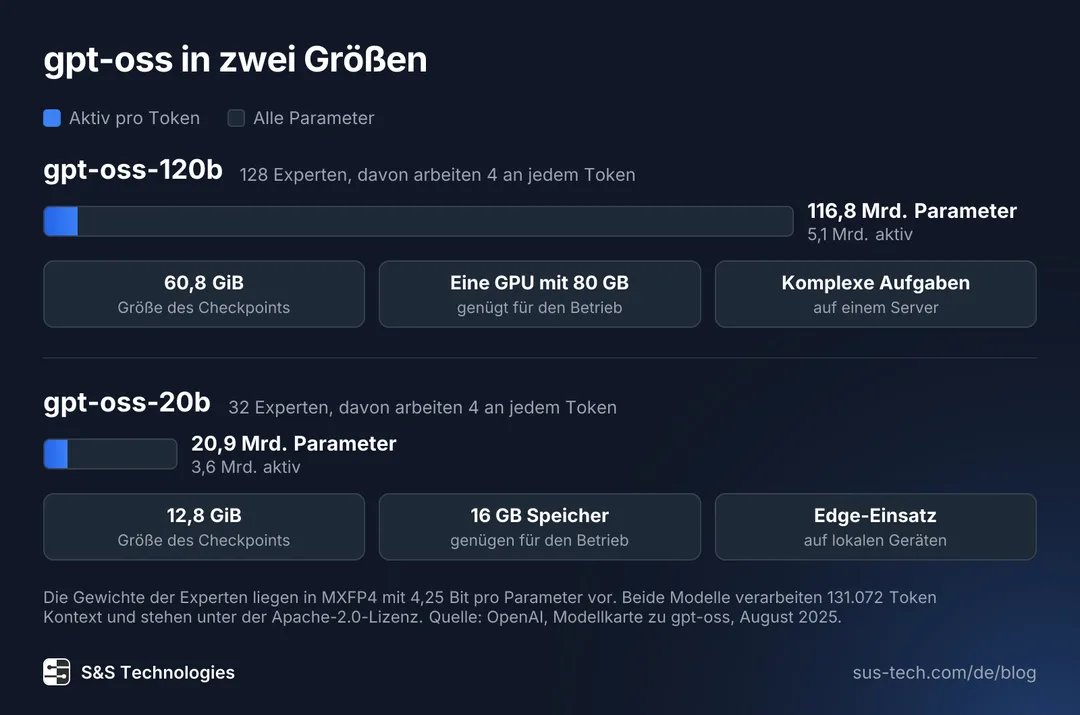
Beide sind Mixture-of-Experts-Modelle. Das größere gpt-oss-120b hat 116,8 Milliarden Parameter, für jedes Token sind aber nur 5,1 Milliarden davon aktiv. Sein Checkpoint belegt 60,8 GiB und passt auf eine einzelne GPU mit 80 GB. Das kleinere gpt-oss-20b hat 20,9 Milliarden Parameter, davon 3,6 Milliarden aktiv. Sein Checkpoint mit 12,8 GiB läuft auf Systemen mit 16 GB Speicher. Beide verarbeiten einen Kontext von 131.072 Token.
Diese Effekte verstärken sich in Kombination mit agentischen Workflows, wie in Kleine Sprachmodelle (SLMs): Agentic AI für Ihre Workflow-Automatisierung beschrieben.
So testen Sie gpt-oss
Open-Source-Modelle sind keine akademische Spielerei mehr - sie sind bereit für den produktiven Einsatz in Ihren Workflows. Ob ITSM-Agent, automatisiertes DSGVO-Reporting oder ERP-Datenpflege: Ihre KI-Infrastruktur bleibt unter Ihrer eigenen Kontrolle.
So gehen Sie weiter vor:
- Identifizieren Sie Ihre zentralen KI-Anwendungsfälle: Wo sind Sie aktuell auf externe APIs angewiesen?
- Bewerten Sie Ihre Compliance-Anforderungen: Werden Audit-Logs benötigt? Enthalten Prompts sensible Personen- oder IP-Daten?
- Analysieren Sie Ihre Kostenstruktur: Wie viele Tokens verbrauchen Ihre Workflows im Monat, wie viele Modellaufrufe gibt es pro Dokument?
- Planen Sie das Deployment: Edge? Rechenzentrum? Hybrid?
- Holen Sie Expertenrat ein: Wir erstellen einen maßgeschneiderten Fahrplan für eine kontrollierte GPT-OSS-Bereitstellung
Kontaktieren Sie unser Team unter office@sus-tech.at, um zu erfahren, wie gpt-oss-Modelle in Ihre KI-Strategie passen.
Automatisieren. Optimieren. Skalieren.