
Kleine Sprachmodelle (SLMs): Agentic AI für Ihre Workflow-Automatisierung

Wussten Sie, dass spezialisierte Sprachmodelle mit weniger als 10 Milliarden Parametern 40 bis 70 % der Modellaufrufe in den von NVIDIA-Forschern untersuchten KI-Agenten zuverlässig übernehmen könnten? Das NVIDIA-Forschungspaper „Small Language Models are the Future of Agentic AI“ schätzt etwa 60 % für MetaGPT, 40 % für Open Operator und 70 % für Cradle, drei Open-Source-Agenten. Laut dem Paper ist der Betrieb eines Modells mit 7 Milliarden Parametern außerdem 10- bis 30-mal günstiger bei Latenz, Energie und Rechenaufwand als der eines Modells mit 70 bis 175 Milliarden Parametern. Für Firmen im DACH-Raum, die mit Latenz, Datenhoheit und Budget kämpfen, ist das ein großer Schritt.
Warum Cloud-LLM-Aufrufe teuer werden
Viele IT-Service-Desks verlassen sich auf Cloud-LLM-APIs, um Tickets zusammenzufassen, ERP-Datensätze anzureichern oder Knowledge-Base-Antworten zu generieren. Hohe Tokenzahlen bedeuten jedoch hohe Rechnungen und externe Calls können sensible Daten durch Rechenzentren im Ausland führen - ein Risiko für die Vertraulichkeit, die Art. 5 Abs. 1 lit. f DSGVO verlangt. Wir haben diese Risiken bereits in DSGVO & KI: Sicheres lokales Hosting für LLMs aufgezeigt.
Hinzu kommen schwankende Round-Trip-Latenzen und unberechenbare Rate-Limits - Ihre Automatisierung wird so schnell vom Hebel zum Risiko.
Ein Automatisierungs-Stack, der mit kleinen Modellen beginnt
S&S Technologies begegnet dem Problem mit einem SLM-first-Automatisierungs-Stack hinter Ihrer Firewall:
- n8n Low-Code-Workflows (mehr erfahren) orchestrieren Datenströme zwischen Ihrer Software.
- Ollama-gehostete Small Language Models (SLMs) laufen auf einer moderaten GPU oder sogar einer starken CPU, fein-getuned auf Ihr Fachvokabular und Ihre Compliance-Filter.
- Eine Smart-Router-Node entscheidet in Echtzeit, ob das lokale SLM reicht oder ob, wenn gewollt, für Sonderfälle ein größeres Cloud-LLM benötigt wird.
- Jede Eingabe, Ausgabe und Modellversion wird durch unsere Governance-Schicht (RBAC, Versionierung, Policy-Nodes, Audit-Trails, Dashboards) lückenlos protokolliert.
So läuft eine Anfrage durch diesen Stack:
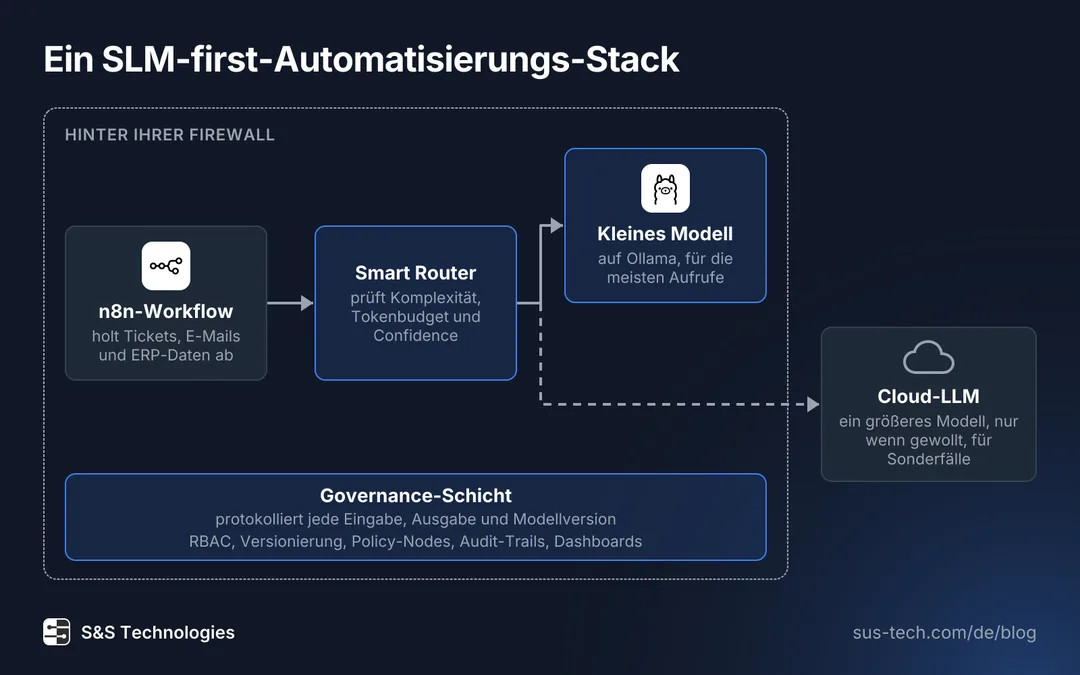
n8n holt Tickets, E-Mails und ERP-Daten ab und übergibt jede Aufgabe an den Smart Router. Er prüft Komplexität, Tokenbudget und Confidence. Die meisten Aufrufe gehen an das kleine Modell auf Ollama und verlassen Ihr Netzwerk nicht. Nur Sonderfälle gehen an ein größeres Cloud-LLM, wenn Sie das wollen. Die Governance-Schicht darunter protokolliert jede Eingabe, Ausgabe und Modellversion, egal welches Modell antwortet.
Warum SLM-first strategisch sinnvoll ist
Das NVIDIA-Papier beschreibt drei Wertdimensionen:
| Wertpfeiler | Erkenntnisse des Papers | Bedeutung für Ihr Unternehmen |
|---|---|---|
| Capability | Aktuelle Modelle unter 10 Mrd. Parametern halten bei Tool-Aufrufen, beim Befolgen von Anweisungen und bei der Codegenerierung mit viel größeren Modellen mit. xLAM-2-8B schlägt bei Tool-Aufrufen sogar GPT-4o und Claude 3.5. | Service-Desk-Makros, Rechnungsextraktion und Statusupdates erfordern selten abstraktes Reasoning. |
| Suitability | Kleinere Architekturen lassen sich leichter fein-tunen, debuggen und iterieren. | Ihr DevOps-Team behält die Kontrolle; keine undurchsichtigen Vendor-Updates. |
| Economy | Deutlich geringere Kosten und weniger Energie pro Token als große Cloud-Modelle. | Budgets reichen weiter - Automatisierung skalieren, ohne den CFO zu überlasten. |
Kurz: SLMs ermöglichen es klein zu starten, schnell zu lernen und vor allem compliant zu bleiben.
Agent-Aufgaben auf kleine Modelle verlagern
- Datenerfassung & Clusterbildung: n8n sammelt historische Tickets, E-Mails und Log-Daten und gruppiert sie in hochfrequente Intent-Cluster, um Automatisierungs-Hotspots zu identifizieren.
- Feintuning oder Distillation: Mit parameter-effizienten Verfahren wie LoRA oder QLoRA passen wir ein 7B-Modell an Ihren Wortschatz und Ihre Red-Lines an. Eine Anleitung zum lokalen Hosten von LLMs/SLMs finden Sie in How To: LLMs lokal ausführen.
- Smart Routing: Ein Decision-Node prüft Aufgabenkomplexität, Tokenbudget und Confidence-Scores; die meisten Aufrufe bleiben lokal, der Rest wird an ein Cloud-LLM eskaliert, falls dies gewollt ist.
- Governance & Optimierungs-Loop: Process-Mining-Nodes benchmarken Durchlaufzeit, Genauigkeit und Human-Overrides und füttern eine kontinuierliche Verbesserungs-Pipeline.
Die vier Schritte wiederholen sich mit jeder Runde:
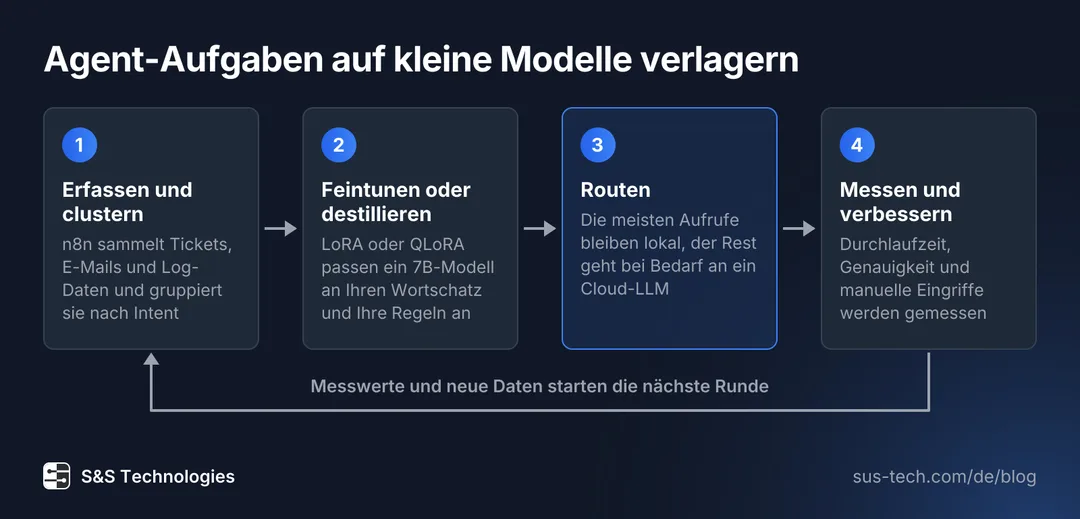
Das Clustering zeigt, welche Aufgaben oft genug vorkommen, um sich für ein kleines Modell zu lohnen. Feintuning mit LoRA oder QLoRA passt ein 7B-Modell an diese Aufgaben an, der Router schickt die passenden Aufrufe dorthin und die Messung von Durchlaufzeit, Genauigkeit und manuellen Eingriffen zeigt, wo es noch nicht reicht. Diese Ergebnisse und neue Tickets starten die nächste Runde.
Was kleine Modelle verändern
- Schnellere Ticket-Bearbeitung dank schneller lokaler Inferenz und On-Prem-KI.
- Niedrigere monatliche Inferenzkosten bei hohen Volumen, Hardware eingerechnet (siehe unseren Kostenvergleich).
- Weniger manuelle Eingriffe bei repetitiven ERP-Einträgen.
- DSGVO-konforme Datenresidenz mit revisionssicheren Logs.
- Reduzierte Vendor-Abhängigkeit: Modelle können ohne Neuverhandlungen ausgetauscht oder neu trainiert werden.
Praxisbeispiele
- Rechnungen im ERP-System: Ein SLM klassifiziert Lieferantenrechnungen, extrahiert Zahlungsbedingungen und stößt automatische Freigabeläufe im ERP an.
- Echtzeit-ITSM-Anreicherung: Während des Incident-Intake fragt das Modell CMDBs und frühere Tickets ab und ergänzt wahrscheinliche Root-Cause-Felder.
- Automatisierter HR-Posteingang: Ein mehrsprachiges 7B-Modell entwirft Antworten auf Routine-Urlaubsanträge und eskaliert nur Policy-Ausnahmen.
- Sales-Ops-Quote-Builder: Das SLM baut konfigurierbare Angebote aus ERP-Preislisten zusammen und reduziert Antwortzeiten in Hochsaisons.
Ein erster Pilot
- Pilotprojekt starten: Wählen Sie eine hochvolumige, risikoarme Aufgabe und mappen Sie diese auf einen KI-Agenten mit einem SLM.
- Konversionsalgorithmus anwenden: Unser SLM-Migrations-Playbook setzt die NVIDIA-Methodik in ein funktionsfähiges n8n-Recipe um.
- ROI quantifizieren: Nutzen Sie Process-Mining-Dashboards, um Durchlaufzeit-Reduktion und Kosten pro Ticket zu messen, und skalieren Sie quartalsweise weiter.
- Sicher skalieren: Coverage schrittweise erhöhen, Rollback-Regeln, Shadow-Tests und Human-Review-Nodes hinzufügen.
Bereit, SLMs in Ihren Workflows einzusetzen? Kontaktieren Sie unser Team für eine Readiness-Analyse und einen Proof-of-Value-Workshop.