
LLM-Finetuning mit LoRA und QLoRA

Das Finetuning großer Sprachmodelle (LLMs) ist für Unternehmen essenziell geworden, die präzise Ausgabequalität in Bereichen wie Recht, Finanzen oder internem Support benötigen. Doch wie lässt sich hochwertige Anpassung erreichen, ohne GPU-Stunden oder das Engineering-Budget zu verbrennen?
Warum volles Finetuning teuer ist
Vollständiges Finetuning eines LLM klingt mächtig - bis man es versucht. Jede Gewichtung in einem 7B- oder 13B-Modell zu aktualisieren bedeutet, pro Trainingsdurchlauf Milliarden von Werten zu verändern. Der GPU-Speicherbedarf steigt stark, Experimente dauern lange und selbst kleine Verbesserungen erscheinen teuer.
Für Organisationen in regulierten oder wissensintensiven Branchen bedeuten Verzögerungen beim Modell-Finetuning:
- Verlust von Wettbewerbsvorteilen in Automatisierung und KI.
- Schwierigkeiten bei der Einhaltung interner oder branchenspezifischer Vorgaben.
- Mehr Druck auf IT-Teams durch manuelle, fehleranfällige Prozesse.
Wie wir in unserem Beitrag RAG vs. Finetuning: Die richtige Strategie für Ihre LLMs beschrieben haben, löst Retrieval-Augmented Generation einige dieser Anforderungen. Wenn Ihr Anwendungsfall jedoch erfordert, dass das Modell Ihre Domäne nativ versteht - nicht nur, wenn es angeleitet wird - ist Finetuning unverzichtbar.
Finetuning mit LoRA und QLoRA
S&S Technologies bietet pragmatisches, kosteneffizientes Finetuning von LLMs mit LoRA (Low-Rank Adaptation) und dessen Weiterentwicklung, QLoRA. Diese Methoden senken deutlich den Rechenbedarf, um ein Foundation Model an Ihre Daten anzupassen - sei es juristische Fachbegriffe, Muster in Finanzdokumenten oder interne Support-FAQs.
Ob Sie einen internen Wissens-Bot, einen KI-gestützten Compliance-Checker oder einen sprachsensiblen ERP-Assistenten entwickeln: unser Team passt LLMs so an, dass sie Ihre Geschäftssprache verstehen - und sprechen. Im Vergleich zu klassischen Ansätzen sind unsere Lösungen:
- Kostenoptimiert durch GPU-effizientes Tuning
- Vollständig integrierbar in Plattformen wie n8n
- Abgestimmt auf Ihre ITSM-, ERP- oder Dokument-Governance-Anforderungen
Wir kombinieren angepasste Modelle mit erprobter Prozessinfrastruktur wie ITSM-Plugins, RAG-Pipelines und Git-basierter Workflow-Governance.
Wie LoRA und QLoRA funktionieren
Die drei Ansätze unterscheiden sich darin, welche Gewichte trainiert werden und wie das Basismodell gespeichert ist:
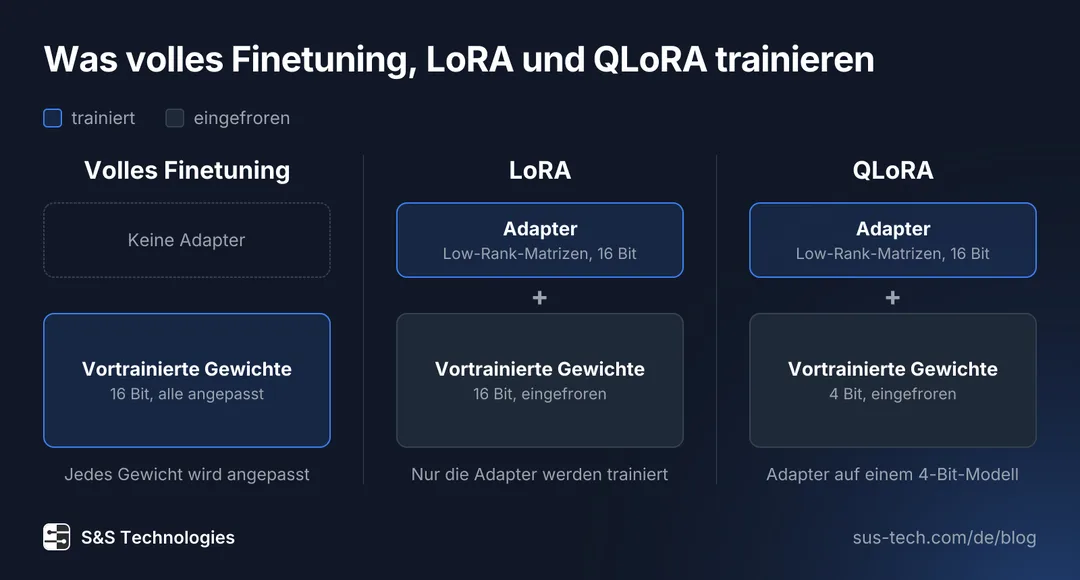
Volles Finetuning passt jedes Gewicht des Modells an. LoRA lässt die vortrainierten Gewichte eingefroren und trainiert nur kleine Low-Rank-Matrizen, die Adapter. QLoRA trainiert dieselbe Art von Adaptern, während das eingefrorene Basismodell in 4 Bit gespeichert ist.
So ermöglichen LoRA und QLoRA effizientes Finetuning:
LoRA (Low-Rank Adaptation)
LoRA steigert die Effizienz, indem nur ein kleiner Teil des Gewichtungsraums angepasst wird:
- Nur kleine Änderungen: Das vortrainierte Modell bleibt erhalten und es werden lediglich kleine Matrizen mit niedrigem Rang zur Anpassung trainiert.
- Speichereinsparung: Für GPT-3 mit 175 Milliarden Parametern nennt das LoRA-Paper 10 000-mal weniger trainierbare Parameter und ein Drittel des GPU-Speichers im Vergleich zum vollständigen Finetuning (Hu et al., 2021). Wie groß ein Adapter ist, hängt vom Rank ab und davon, wie viele Gewichtsmatrizen einen bekommen.
- Anpassbarer Rank: Je nach Komplexität Ihrer Domäne setzen wir den Rank von LoRA zwischen 8 und 256. Für GPT-3 reichte im LoRA-Paper schon ein Rank von eins oder zwei, ein höherer Rank bringt LoRA näher an das vollständige Finetuning.
QLoRA (Quantisiertes LoRA)
QLoRA erweitert LoRA, indem es die Präzision beim Training reduziert:
- 4-Bit-Quantisierung verringert den Speicherbedarf deutlich.
- Gleiche Qualität: Das QLoRA-Paper hat ein Modell mit 65 Milliarden Parametern auf einer einzelnen 48-GB-GPU feinjustiert und die Ergebnisse des 16-Bit-Finetunings erreicht (Dettmers et al., 2023). Für jede Berechnung werden die Gewichte in 16 Bit zurückgerechnet.
- Full-Layer-Adaptation: Dasselbe Paper zeigt, dass Adapter auf allen linearen Schichten des Transformers nötig sind, um die Qualität des vollständigen Finetunings zu erreichen.
Plattformintegration
Wir binden feinjustierte Modelle direkt in bestehende Geschäftsabläufe ein:
- Integration in n8n-Flows, die S3-Buckets, ERP-Exporte oder Compliance-Dokumente überwachen.
- Anbindung an ITSM-Benutzeroberflächen und ERP-Hilfe-Panels.
- Vollständig kontrolliert durch rollenbasierte Zugriffe und Audit-Trails - wie in unserem Beitrag Interne Wissensdatenbanken mit RAG: Architektur, Tools und Wartung.
Was effizientes Finetuning bringt
Mit LoRA und QLoRA profitieren Unternehmen von:
- Deutlich geringeren Rechen- und Cloudkosten für die Anpassung als beim vollständigen Finetuning, wie die Zahlen des LoRA-Papers oben zeigen.
- Schnelleren Release-Zyklen durch kleinformatige, modulare Modelländerungen.
- Höherer Domänenspezifität, die kontextgenaue Antworten ermöglicht.
- Antworten, die sich leichter prüfen lassen: Ein auf Ihre Beispiele abgestimmtes Modell hält Ihr Format und Ihre Begriffe ein.
Beide Papers nennen, wie viel GPU-Speicher das Training mit und ohne Adapter braucht:
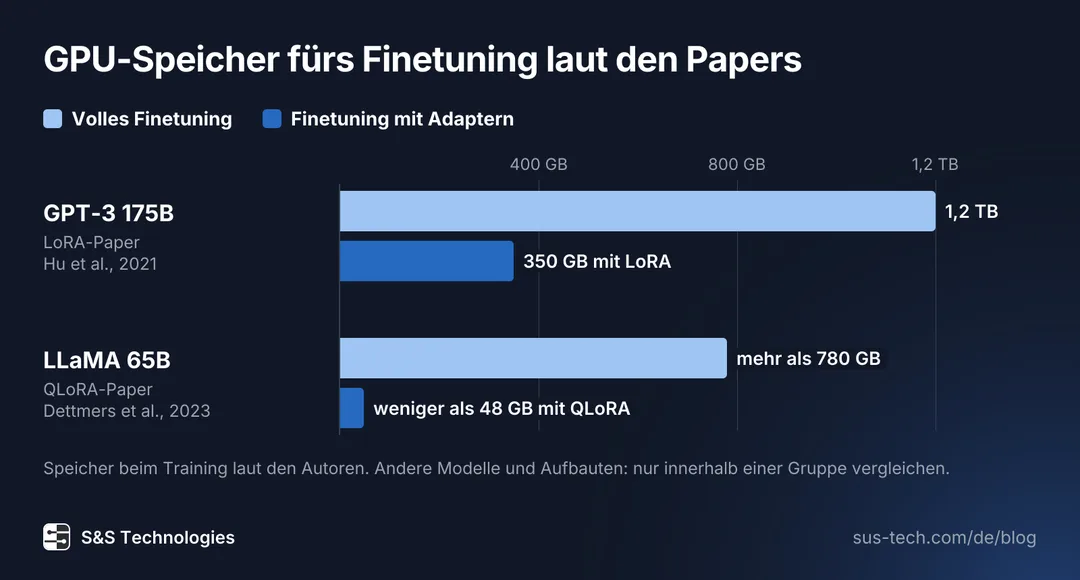
Bei GPT-3 mit 175 Milliarden Parametern senkte LoRA den GPU-Speicher für das Training von 1,2 TB auf 350 GB (Hu et al., 2021). Für LLaMA 65B braucht volles Finetuning in 16 Bit mehr als 780 GB GPU-Speicher, QLoRA weniger als 48 GB (Dettmers et al., 2023). Die beiden Papers haben unterschiedliche Modelle gemessen, die Zahlen zeigen also die Größenordnung der Einsparung und keinen direkten Vergleich von LoRA und QLoRA.
In Kombination mit internen Datenpipelines lassen sich Support- und Onboarding-Aufgaben skalierbar automatisieren - wie bei Kunden, die unsere n8n-Workflows mit kleinen Sprachmodellen nutzen.
Wie ein Finetuning-Projekt abläuft
Möchten Sie ein Sprachmodell mit LoRA oder QLoRA für Ihre Domäne anpassen? So läuft ein typischer Prozess:
- Erstgespräch: Ziele, Datenlage und relevante Workflows klären.
- Datensatzvorbereitung: Fachinhalte sicher erfassen und strukturieren.
- Modellwahl und Tuning: Ein Basismodell auswählen und mit LoRA bzw. QLoRA justieren.
- Workflow-Integration: Das feinjustierte Modell in Ihre n8n-, ERP- oder ITSM-Systeme einfügen.
- Governance & Monitoring: Leistung überwachen und Update-Flexibilität sichern.
Kontaktieren Sie uns unter office@sus-tech.at, um zu besprechen, wie S&S Technologies ein LLM für Ihren Anwendungsfall anpassen kann - mit effizienter, kontrollierter Automatisierung. Automatisieren. Optimieren. Skalieren.